Flume+Kafka+Flink+Redis构建大数据实时处理系统(单机环境)--环境篇
大体流程:
- python readlog 读取本地日志文件发送到flume(本测试基于原有项目,原有项目是有scribe接收日志存到本地。正式项目flume直接读取本地文件 source改为直接监控日志文件 a1.sources.r1.type = exec, a1.sources.r1.command = tail -F /var/log/secure)
flume sink 数据到kafka
flink scala消费kafka
存入到redis
django展示
这里原应有一个流程图,但是不知道为何markdown不支持flow流程图
graph LR |
本机系统:
Ubuntu 16.04 |
需要安装的环境:
jdk1.8.0_202,scala 2.11.6 ,zookeeper-3.4.5,kafka_2.11-2.3.0,flume-1.8.0,flink-1.8.0 |
1.安装java环境
- 这里安装1.8
环境存放到 cd /opt/
(这里是用华为的镜像地址下载,oracle需要登陆账号)
解压到指定目录 tar -zxvf jdk-8u202-linux-x64.tar.gz
vim ~/.bashrc 添加环境变量如下
export JAVA_HOME=/opt/jdk1.8.0_202 ## 这里要注意目录要换成自己解压的jdk 目录 |
立即生效:
source ~/.bashrc |
2.安装scala
这里安装2.11版本
spark和scala版本对应关系: spark1.6.2–scala2.10 spark2.0.0–scala2.11
本机还要安装spark2.0所以这里安装的是2.11.6
wget https://downloads.lightbend.com/scala/2.11.6/scala-2.11.6.tgz |
3.安装zookeeper
下载 wget http://archive.apache.org/dist/zookeeper/zookeeper-3.4.5/zookeeper-3.4.5.tar.gz |
拷贝配置文件 cp zoo_sample.cfg zoo.cfg
vim zoo.cfg 添加如下内容
修改zookeeper数据存放地址,dataDir,dataLogDir |
- 新建添加的zk数据目录
mkdir /data/zookeeper/data |
- vim /etc/profile 添加环境变量
export ZOOKEEPER_HOME=/opt/zookeeper-3.4.5 |
source /etc/profile 立即生效
进入zk解压目录
cd /opt/zookeeper-3.4.5启动
bin/zkServer.sh start此命令会在当前目录创建日志文件
输出以下代表已启动正常,如有错误查看当前目录日志 zookeeper.out
JMX enabled by default
Using config: /opt/zookeeper-3.4.5/bin/../conf/zoo.cfg
Starting zookeeper … STARTED
查看启动状态:
bin/zkServer.sh status
输出:
JMX enabled by default
Using config: /opt/zookeeper-3.4.5/bin/../conf/zoo.cfg
Mode: standalone
4.安装kafka
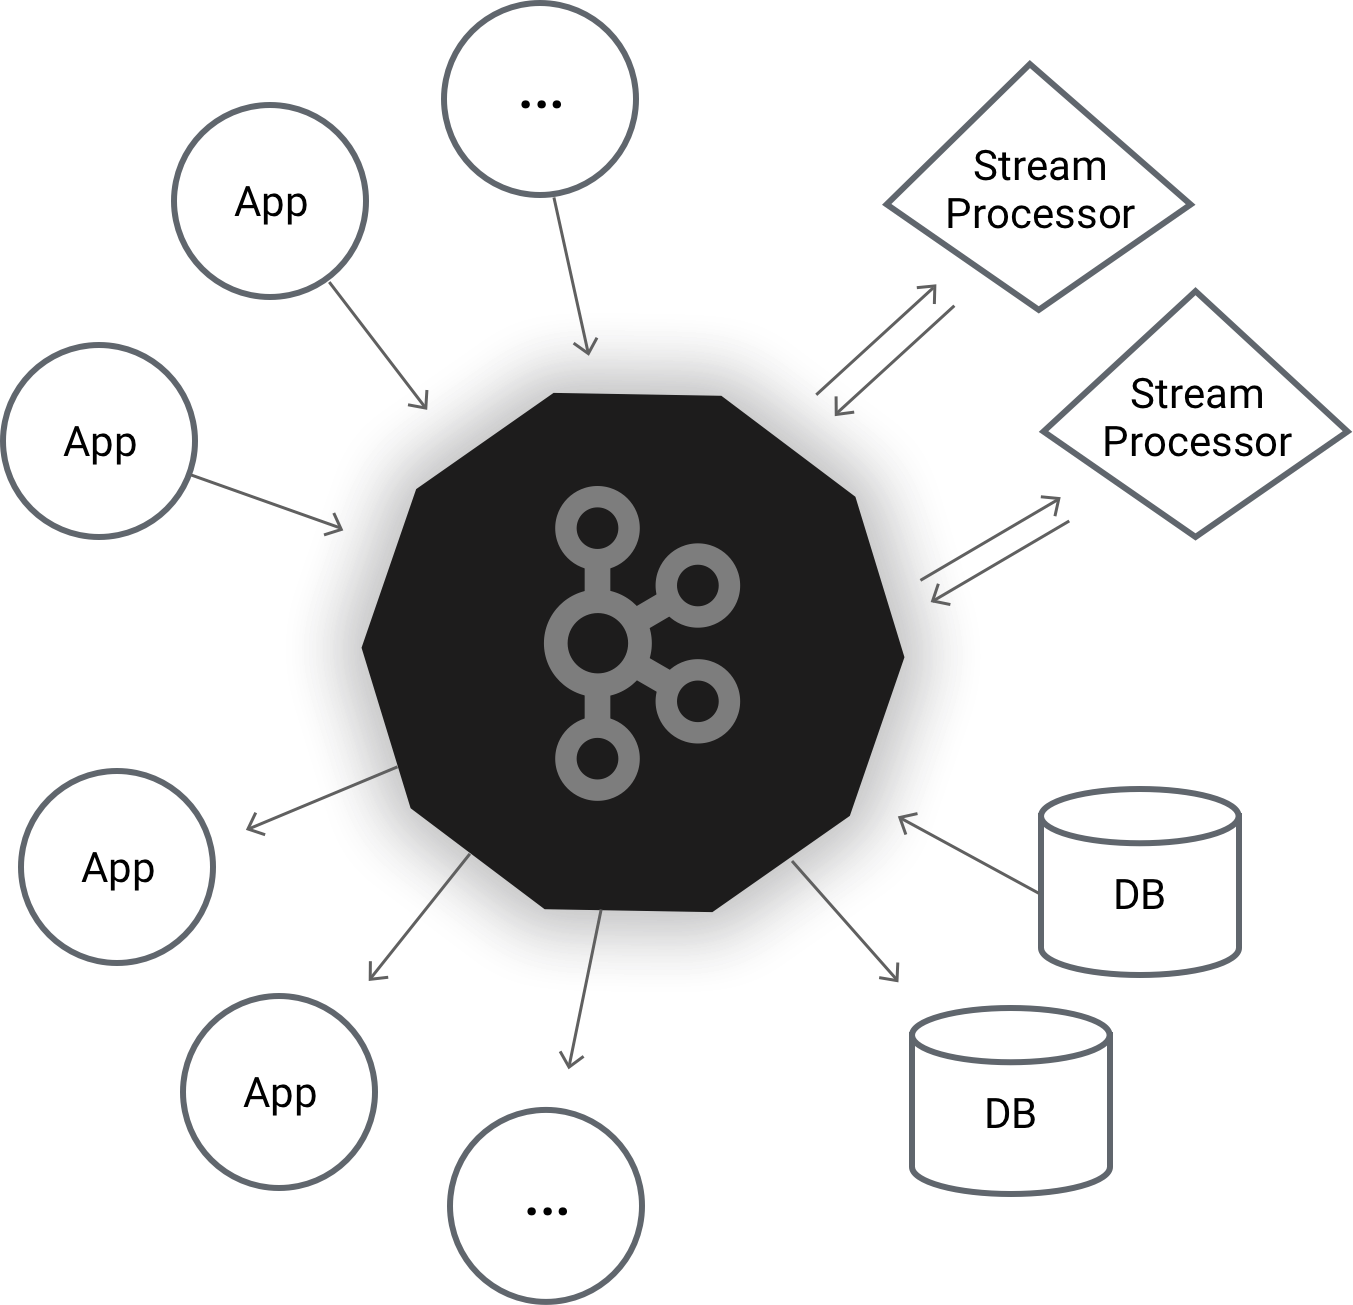
这里安装 2.3.0
kafka_2.11-2.3.0 2.11为scala版本,kafka版本为2.3.0
下载
wget https://www.apache.org/dyn/closer.cgi?path=/kafka/2.3.0/kafka_2.11-2.3.0.tgz解压
tar -zxvf kafka_2.11-2.3.0.tgz -C /opt/kafka_2.11-2.3.0添加环境变量
vi ~/.bash_profile |
立即生效 source ~/.bash_profile
- kafka需要使用Zookeeper,所以需要启动Zookeeper服务,上面的操作就已经启动了Zookeeper服务
如果没有的话,可以使用kafka自带的脚本启动一个简单的单一节点Zookeeper实例
cd /opt/kafka_2.11-2.3.0/ |
- 现在启动kafka(前台执行,会打印日志)
bin/kafka-server-start.sh config/server.properties
后台执行
//配置了环境变量,1代表标准输出,2代表错误输出,把2重定向到标准输出1需要使用&,最后的&表示后台运行 |
创建一个主题,只使用单个分区一个复本
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test启动生产者发送消息
bin/kafka-console-producer.sh --broker-list localhost:9092 --topic test
Hello Kafka
另开终端启动消费者进行消费信息
bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test
消费者成功打印出
Hello Kafka
kafka相关命令
//启动kafka |
如果后期开发的话需要对kafka配置进行修改 server.properties
其他参数没有深究,其他配置可以参考官网说明
//用于区分broker,必须唯一 |
advertised.listeners是个坑,这里说明下,也是让自己长点记性
官方解释:
Listeners to publish to ZooKeeper for clients to use, if different than the listeners above.
In IaaS environments, this may need to be different from the interface to which the broker binds.
If this is not set, the value for listeners will be used.
下面是默认配置,没有修改:
#listeners=PLAINTEXT://:9092 |
注释的两个参数,虽然注释了,但是通过介绍可以知道,这两个参数,可以通过java.net.InetAddress.getCanonicalHostName获得,也就是可以获取到127.0.0.1 这样的话,本机测试是可以正常消费和生产数据的,但外网不行。
经各种测试后发现,修改kafka的advertised.listeners 为外网ip 即可:
#listeners=PLAINTEXT://:9092 |
5.flume安装
- Flume
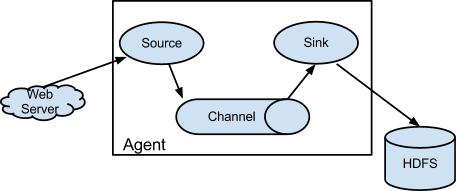
wget http://archive.apache.org/dist/flume/1.8.0/apache-flume-1.8.0-bin.tar.gz |
添加环境变量
vi ~/.bash_profile |
立即生效 source ~/.bash_profile
进入解压目录修改配置cd /opt/flume-1.8.0/conf/mv flume-env.sh.template flume-env.sh
vim flume-env.sh 去掉注释,配置正确的java路径export JAVA_HOME=/opt/jdk1.8.0_202
验证 flume-ng version 输出:
Flume 1.8.0
Source code repository: https://git-wip-us.apache.org/repos/asf/flume.git
Revision: 99f591994468633fc6f8701c5fc53e0214b6da4f
Compiled by denes on Fri Sep 15 14:58:00 CEST 2017
From source with checksum fbb44c8c8fb63a49be0a59e27316833d
拷贝并修改配置cp flume-conf.properties.template flume-conf.properties
使用官方配置,官方配置使用netcat源,更多源查看官方网站https://flume.apache.org/releases/content/1.9.0/FlumeUserGuide.html#spooling-directory-source
#example.conf: A single-node Flume configuration |
启动验证bin/flume-ng agent --conf conf --conf-file conf/flume-conf.properties --name a1 -Dflume.root.logger=INFO,console
另起窗口输入,然后输入内容,前面的终端会输出内容,测试成功。
telnet localhost 44444
- 这里要使用,Thrift源。因为项目中原本要兼容flume+scribe,新建配置 flume-thrift.properties,接收python发送过来的日志
tier1.sources = source1 |
关于selector参数的说明:
它的type 有** Multiplexing , Replicating** , 这里是用selector来根据header的GAMENAME内容分发到对应的channel,暂时不做存储。(项目需要本地,hdfs分别一份,每个项目需要两个channel)
区别是:Replicating 会将source过来的events发往所有channel,而Multiplexing 可以选择该发往哪些channel
之前没有设置会出现Thrift source %s could not append events to the channel.
查阅资料,这和memory channel的另一个参数有关:
transactionCapacity,(The maximum number of events the channel will take from a source or give to a sink per transaction)表明source给channel、channel给sink一次发送的event个数,如果不设置,默认值为100。所以当我设置batchsize为100时,可以正确发送,但是超过100,就发送失败。
关于参数** transactionCapacity ** 和** capacity ** :
a1.sinks.k1.hdfs.batchSize 官方解释:
##number of events written to file before it is flushed to HDFS
a1.channels.c1.capacity 官方解释 :
#The maximum number of events stored in the channel
a1.channels.c1.transactionCapacity 官方解释 :
#The maximum number of events the channel will take from a source or give to a sink per transaction
这三者之间的关系:
batchsize <=transactionCapacity<=capacity
6.flink安装
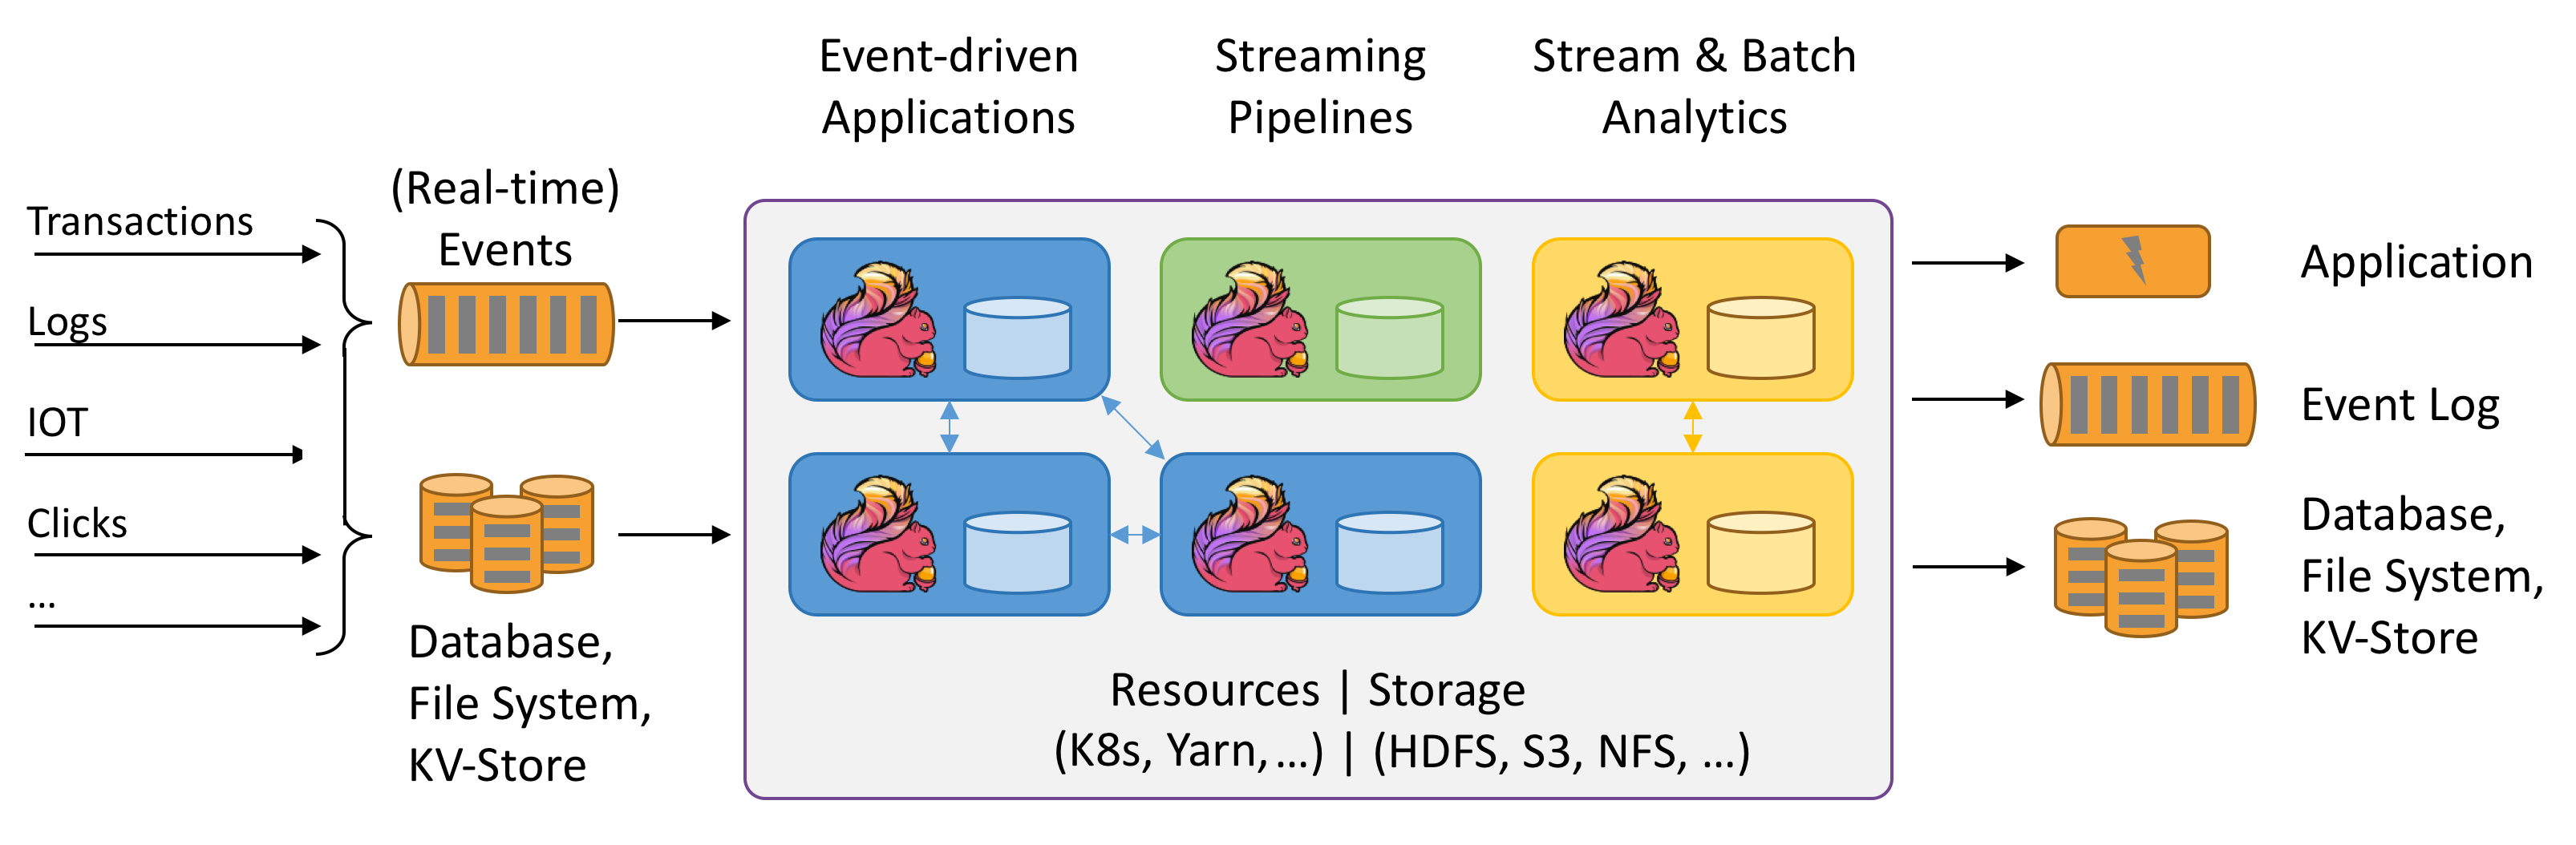
wget https://archive.apache.org/dist/flink/flink-1.8.0/flink-1.8.0-bin-scala_2.11.tgz |
启动flink bin/start-cluster.sh
查看web http://localhost:8081
- 测试 nc -l 9000 输入
hello flink
启动官方demo./bin/flink run examples/streaming/SocketWindowWordCount.jar --port 9000
查看日志log目录下
tail -f flink-root-taskexecutor-0-xxxxxxxxx.out
输出:
(hello,1)
(flink,1)
至此环境搭建完成。